
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
PDF-Craft: Gescannte Buch-PDFs in Markdown/EPUB konvertieren
小编 ·

PDF-Craft: Gescannte Buch-PDFs in Markdown/EPUB konvertieren
Was ist PDF-Craft?
PDF-Craft ist ein Open-Source-Projekt zur Verarbeitung von PDF-Dateien. Es konzentriert sich darauf, gescannte Buch-PDFs in das Markdown- oder EPUB-Format zu konvertieren. Es erkennt Text mittels OCR-Technologie und nutzt ai-Algorithmen, um Text zu extrahieren sowie Kopf- und Fußzeilen zu filtern, um strukturierte Inhalte zu erzeugen. Es unterstützt lokale Berechnung sowie LLM-gestützte Funktionen und eignet sich für die Formatkonvertierung von wissenschaftlichen Arbeiten, Broschüren und langen Büchern.
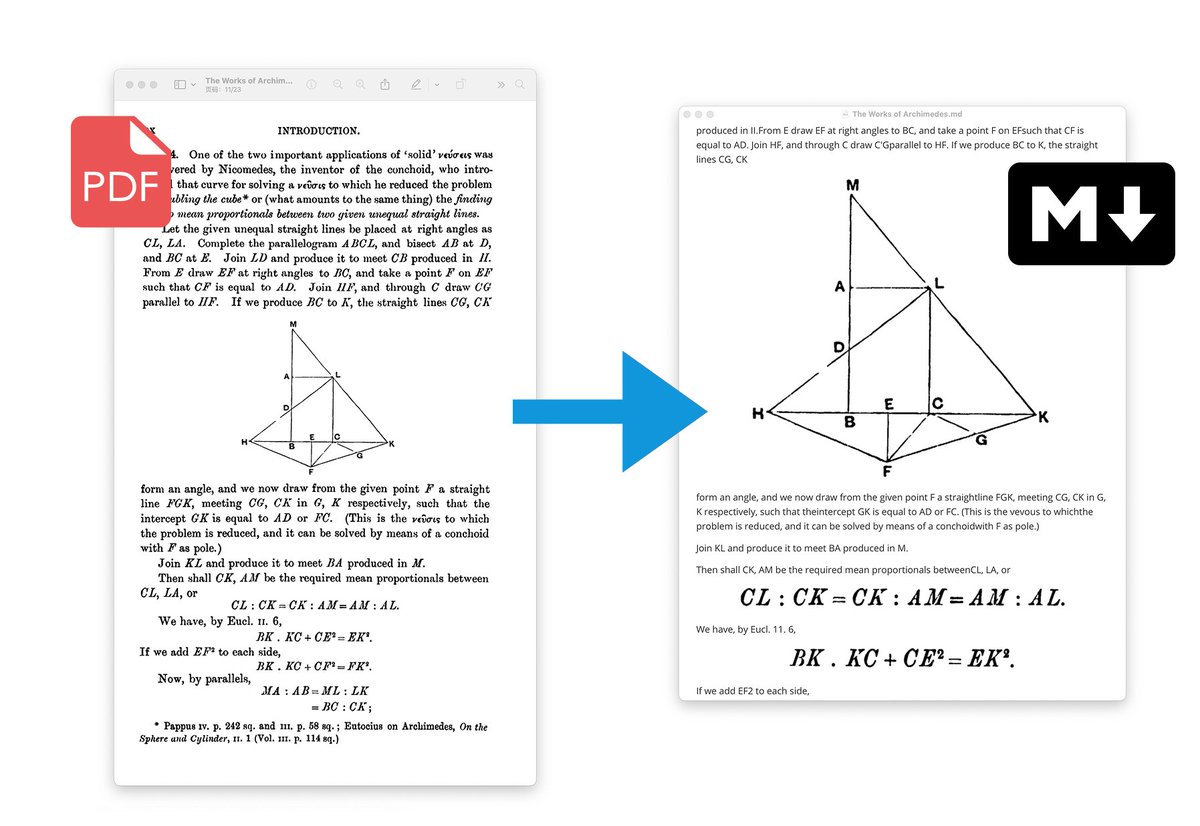
Funktionsmerkmale von PDF-Craft
Formatkonvertierung:
Unterstützt die Konvertierung von PDFs in das Markdown-Format, geeignet für Arbeiten oder kleine Bücher.
Bei mehr als 100 Seiten werden lokale OCR und Cloud-LLM kombiniert, um EPUB-Dateien mit Inhaltsverzeichnis und Kapiteln zu erzeugen.
Intelligente Extraktion:
Verwendet DocLayout-YOLO und benutzerdefinierte Algorithmen zur Extraktion des Haupttextes und filtert Kopfzeilen, Fußzeilen, Fußnoten, Seitenzahlen und andere Elemente heraus.
Bei seitenübergreifendem Inhalt verarbeitet der Algorithmus den nahtlosen Übergang des Kontexts.
OCR-Erkennung:
Verwendet OnnxOCR zur Texterkennung, unterstützt Screenshots von Illustrationen, Tabellen und Formeln und fügt diese direkt in die Ausgabedatei ein.
Optimierung der Lesereihenfolge:
Bestimmt die Reihenfolge durch layoutreader entsprechend den menschlichen Lesegewohnheiten.
LLM-Unterstützung:
Während der EPUB-Konvertierung werden über LLM (z. B. DeepSeek) Anmerkungen und Zitatinformationen gelesen und im EPUB dargestellt.
Das LLM kann in gewissem Maße auch OCR-Fehler korrigieren.
Lokaler Betrieb:
Unterstützt CPU- und GPU-Beschleunigung, die meisten Vorgänge können ohne Internetverbindung durchgeführt werden.
Anwendungsszenarien von PDF-Craft
Wissenschaftliche Forschung: Konvertierung gescannter wissenschaftlicher Arbeiten in das Markdown- oder EPUB-Format zur einfachen Bearbeitung und Lektüre.
E-Book-Erstellung: Konvertierung gescannter Bücher in das EPUB-Format, um E-Books mit Inhaltsverzeichnis und Kapiteln zu erzeugen.
Dokumentenverarbeitung: Extraktion von Text und Bildern aus PDFs zur weiteren Bearbeitung oder Archivierung.
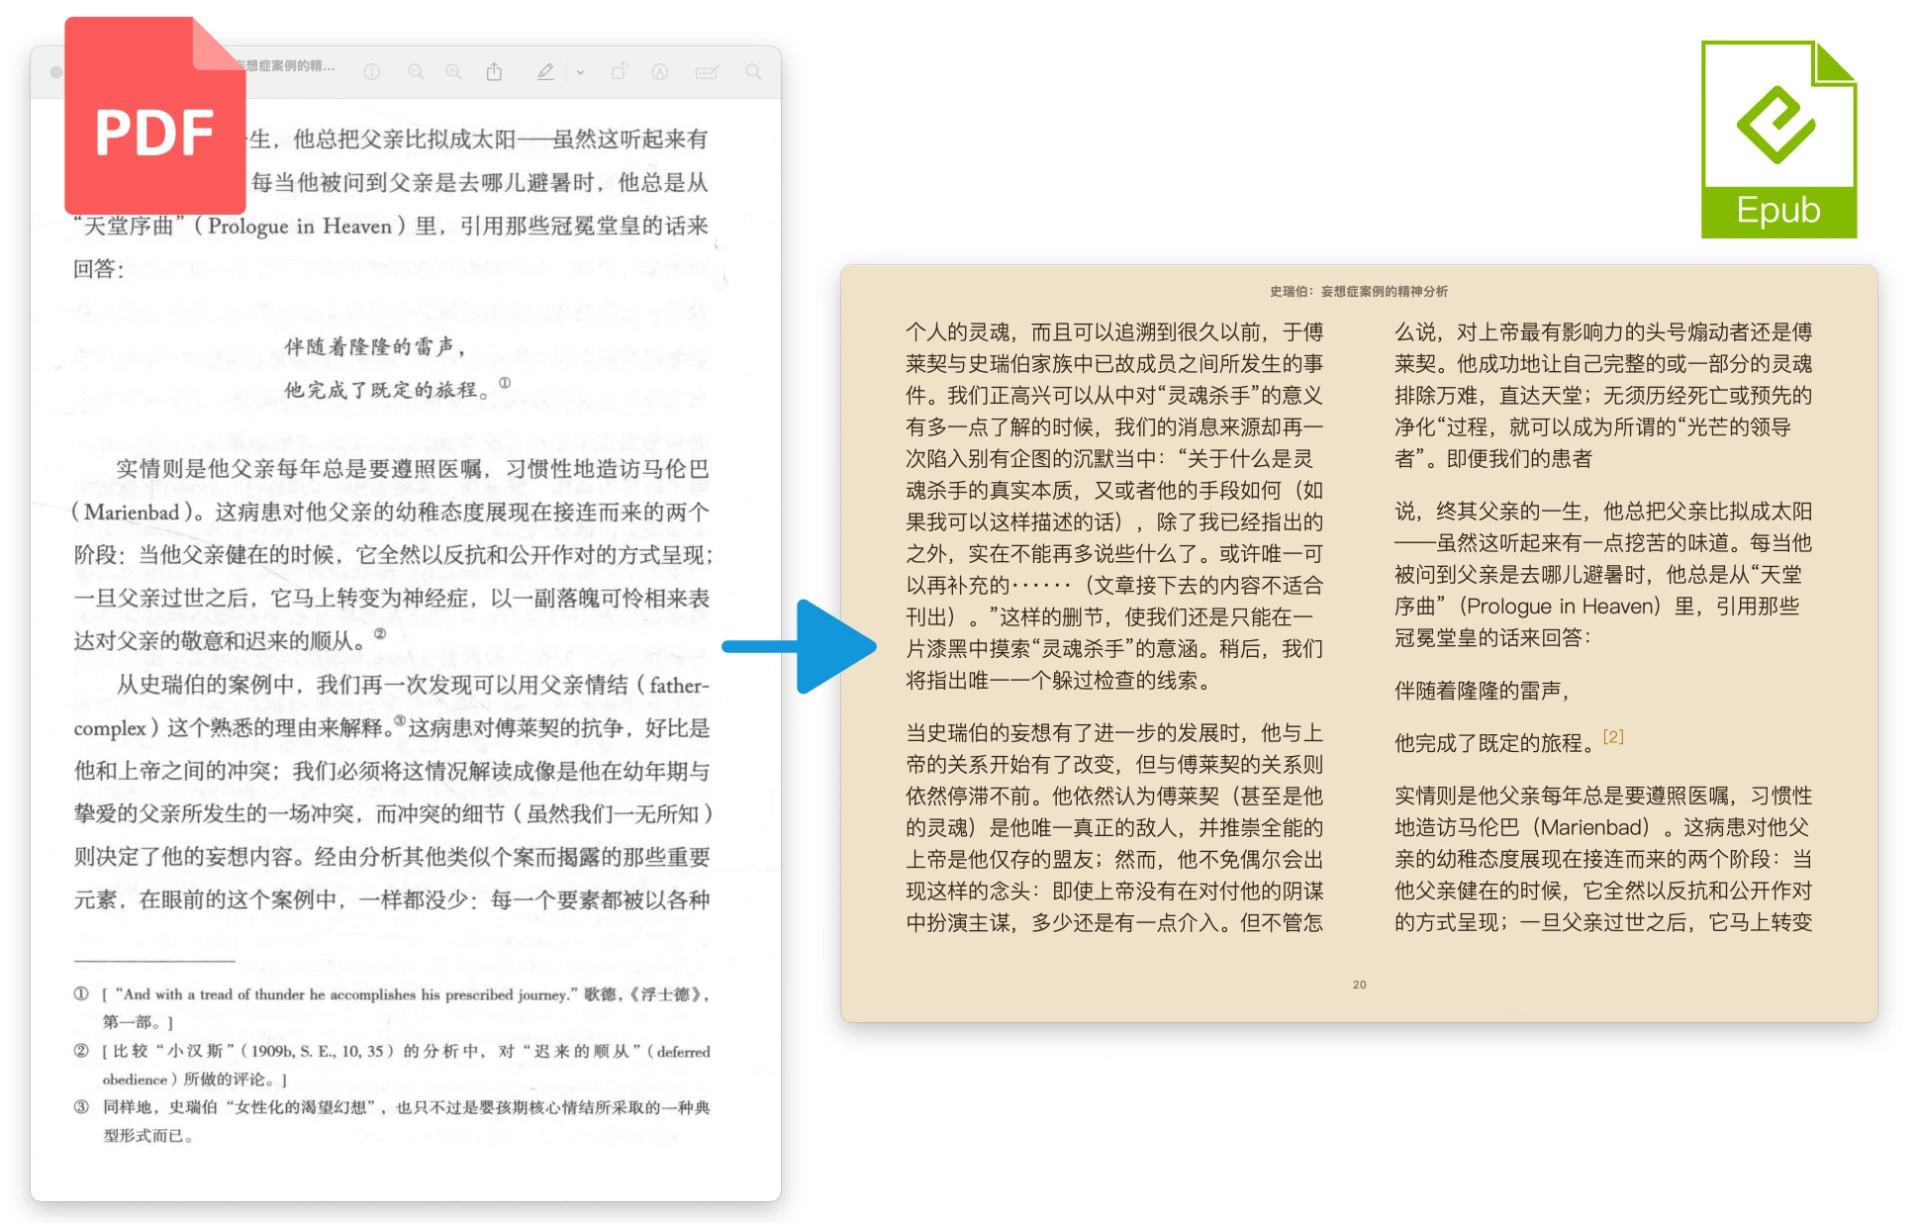
Verwendung von PDF-Craft
1. Installation: Es wird Python 3.10 oder höher benötigt, CUDA-Beschleunigung wird unterstützt.
2. PDF zu Markdown:
from pdf_craft import PDFPageExtractor, MarkDownWriter
extractor = PDFPageExtractor(device="cpu", model_dir_path="/path/to/model")
with MarkDownWriter(markdown_path, "images", "utf-8") as md:
    for block in extractor.extract(pdf="/path/to/pdf"):
        md.write(block)
3. PDF zu EPUB:
from pdf_craft import PDFPageExtractor, LLM, analyse, generate_epub_file
extractor = PDFPageExtractor(device="cpu", model_dir_path="/path/to/model")
llm = LLM(key="sk-XXXXX", url="https://api.deepseek.com", model="deepseek-chat")
analyse(llm=llm, pdf_page_extractor=extractor, pdf_path="/path/to/pdf", analysing_dir_path="/path/to/analysing", output_dir_path="/path/to/output")
generate_epub_file(from_dir_path="/path/to/output", epub_file_path="/path/to/output.epub")
GitHub-Projekt: https://github.com/oomol-lab/pdf-craft









