
 Assistant scénario▸
 Apps AI
 Actualités AI
OpenAI a lancé trois nouveaux modèles vocaux : deux语音转文本 et un文本转语音
小编 ·

OpenAI a lancé trois nouveaux modèles vocaux : deux语音转文本 et un文本转语音
Le 20 mars 2025, Openai a publié trois nouveaux modèles vocaux, dont deux modèles de conversion de la parole en texte (GPT-4o-transcribe et GPT-4o-mini-transcribe) ainsi qu'un modèle de conversion de texte en parole (GPT-4o-mini-tts).
Modèles de conversion de la parole en texte
GPT-4o-transcribe :Ce modèle a été entraîné sur des ensembles de données audio diversifiés et de haute qualité pendant une longue période, ce qui lui permet de mieux saisir les nuances de la parole, de réduire les erreurs de reconnaissance et d'améliorer considérablement la fiabilité de la transcription. Il convient au traitement de scénarios complexes tels que des accents variés, des environnements bruyants et des variations de débit vocal, par exemple dans les domaines des centres d'appels clients et de la transcription de comptes rendus de réunions.
GPT-4o-mini-transcribe :Il s'agit d'une version allégée de GPT-4o-transcribe, plus rapide et plus efficace. Bien que son taux d'erreur sur les mots (WER) soit légèrement supérieur à celui du modèle complet, il reste supérieur à celui de l'ancien modèle Whisper et convient davantage aux scénarios d'application disposant de ressources limitées mais nécessitant une reconnaissance vocale de haute qualité.
Modèle de conversion de texte en parole
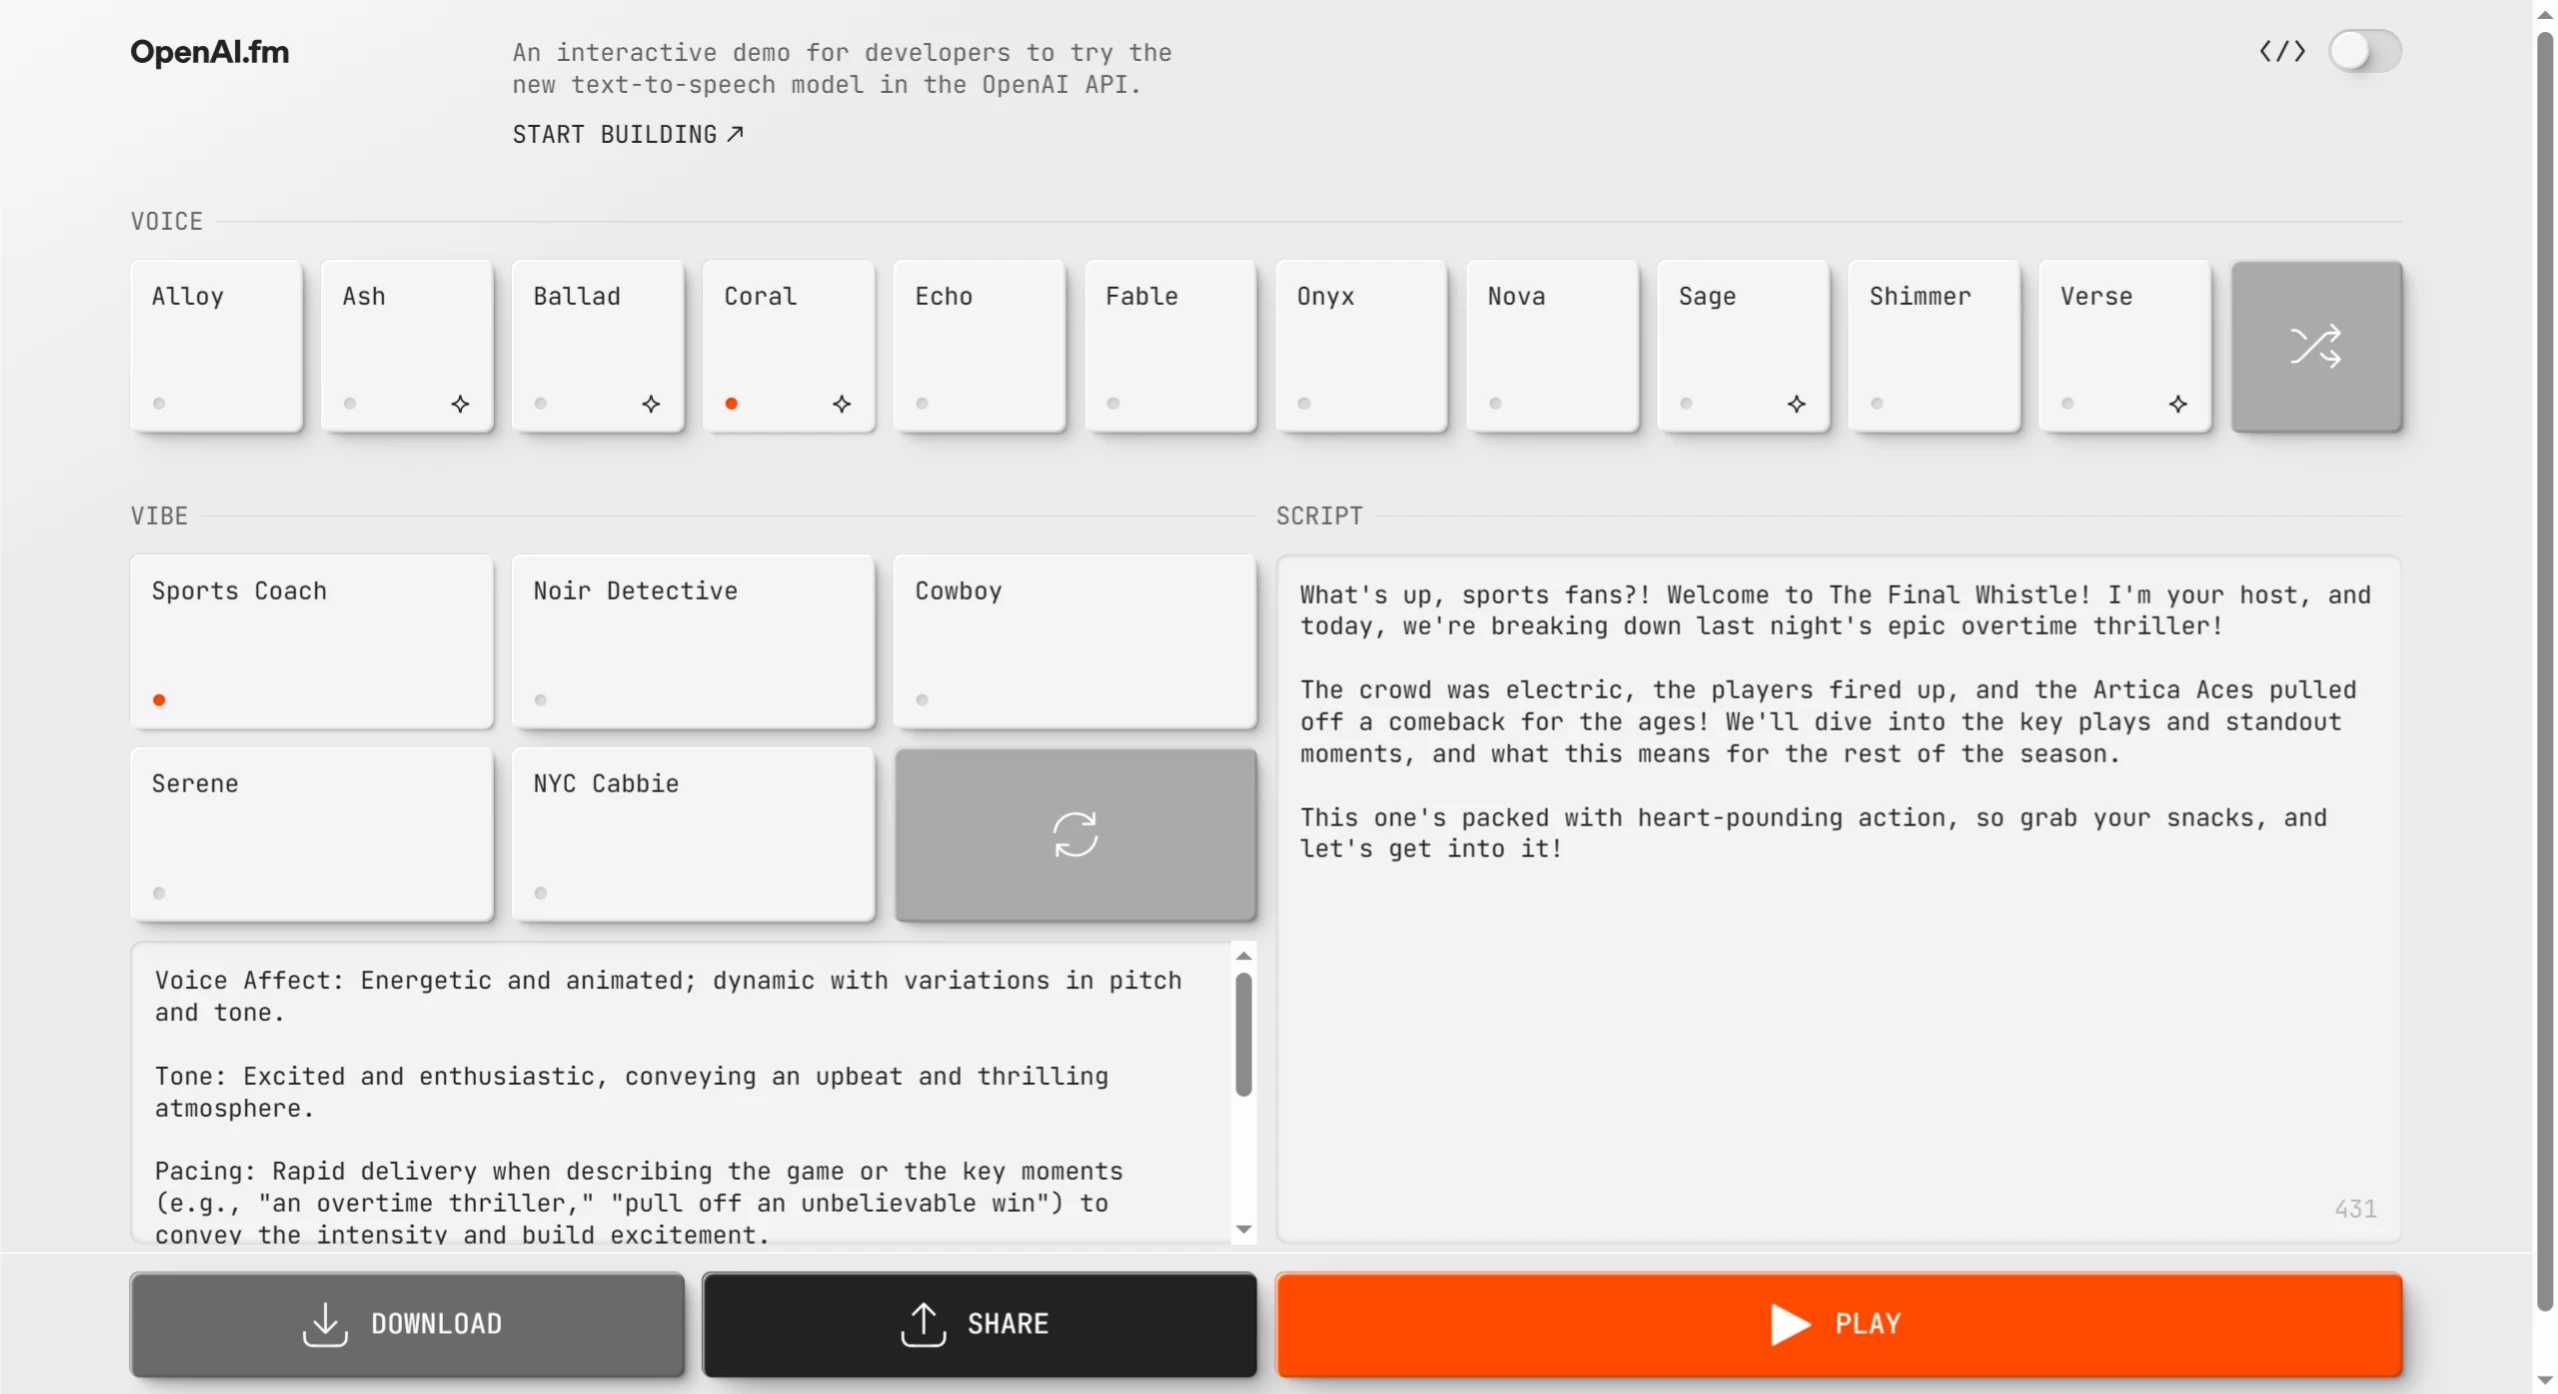
GPT-4o-mini-tts :Ce modèle prend en charge pour la première fois la « guidabilité » (steerability), permettant aux développeurs non seulement de spécifier « ce que » le modèle doit dire, mais aussi de contrôler « comment » il le dit. Par exemple, il est possible de prédéfinir le style vocal sur « calme », « surfeur », « professionnel », « chevalier médiéval », etc., et d'ajuster le style vocal en fonction d'instructions telles que « parle comme un agent du service client compatissant ».
Innovations technologiques
Utilisation d'ensembles de données audio réels pour le pré-entraînement, afin d'optimiser les performances du modèle.
Méthode de distillation améliorée, permettant le transfert de connaissances d'un grand modèle vers un modèle plus petit.
Apprentissage par renforcement, améliorant la précision de la transcription et réduisant les phénomènes d'« hallucination ».
Scénarios d'application
Centres d'appels : fournir une reconnaissance vocale plus précise et une synthèse vocale plus naturelle, afin d'améliorer l'expérience du service client.
Comptes rendus de réunions : transcrire rapidement et avec précision le contenu vocal des réunions en texte.
Service client personnalisé : grâce à la personnalisation du style vocal, offrir une expérience vocale plus chaleureuse et expressive.
Récits créatifs : ajouter des effets vocaux vivants aux histoires.
Tarification
Le prix de GPT-4o-transcribe est identique à celui de l'ancien modèle Whisper, soit 0,006 dollar par minute.
Le prix de GPT-4o-mini-transcribe est de 0,003 dollar par minute.
La tarification de GPT-4o-mini-tts est de 1 cent par minute.
Site web des modèles vocaux d'OpenAI : OpenAI.fm, le site propose de nombreux modèles prédéfinis, incluant des réglages de personnage, de ton, de dialecte et de prononciation. Les utilisateurs peuvent y découvrir et créer des fichiers audio liés à GPT-4o-mini-tts. De plus, OpenAI propose également une version améliorée de l'Agent SDK, aidant les développeurs à concevoir plus facilement des agents vocaux intelligents.
Site officiel :http://openai.fm/
Blog officiel :https://openai.com/index/introducing-our-next-generation-audio-models/









