
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
SWE-Lancer: OpenAIs Open-Source-Benchmark für Software-Engineering-Fähigkeiten
小编 ·

SWE-Lancer: OpenAIs Open-Source-Benchmark für Software-Engineering-Fähigkeiten
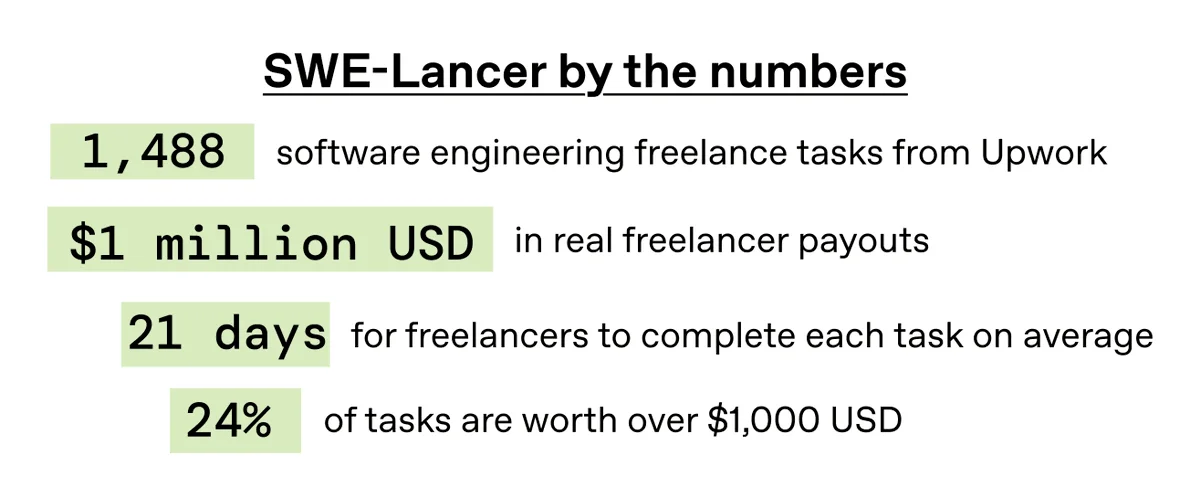
SWE-Lancer ist ein von Openai eingeführter Benchmark, der hauptsächlich zur Bewertung der Leistungsfähigkeit von Modellen bei der Bearbeitung von Open-Source-Softwareentwicklungsaufgaben dient. Dieser Test sammelt über 1.400 Aufgaben von Upwork mit einem Gesamtwert von rund 1 Million US-Dollar. SWE-Lancer konzentriert sich auf die Bewertung von Code-Patches und Managemententscheidungen, indem das Modell aus mehreren Optionen den besten Vorschlag auswählt, um die Arbeitsabläufe in einem Engineering-Team möglichst realistisch zu simulieren.
Kernbewertungsdimensionen:
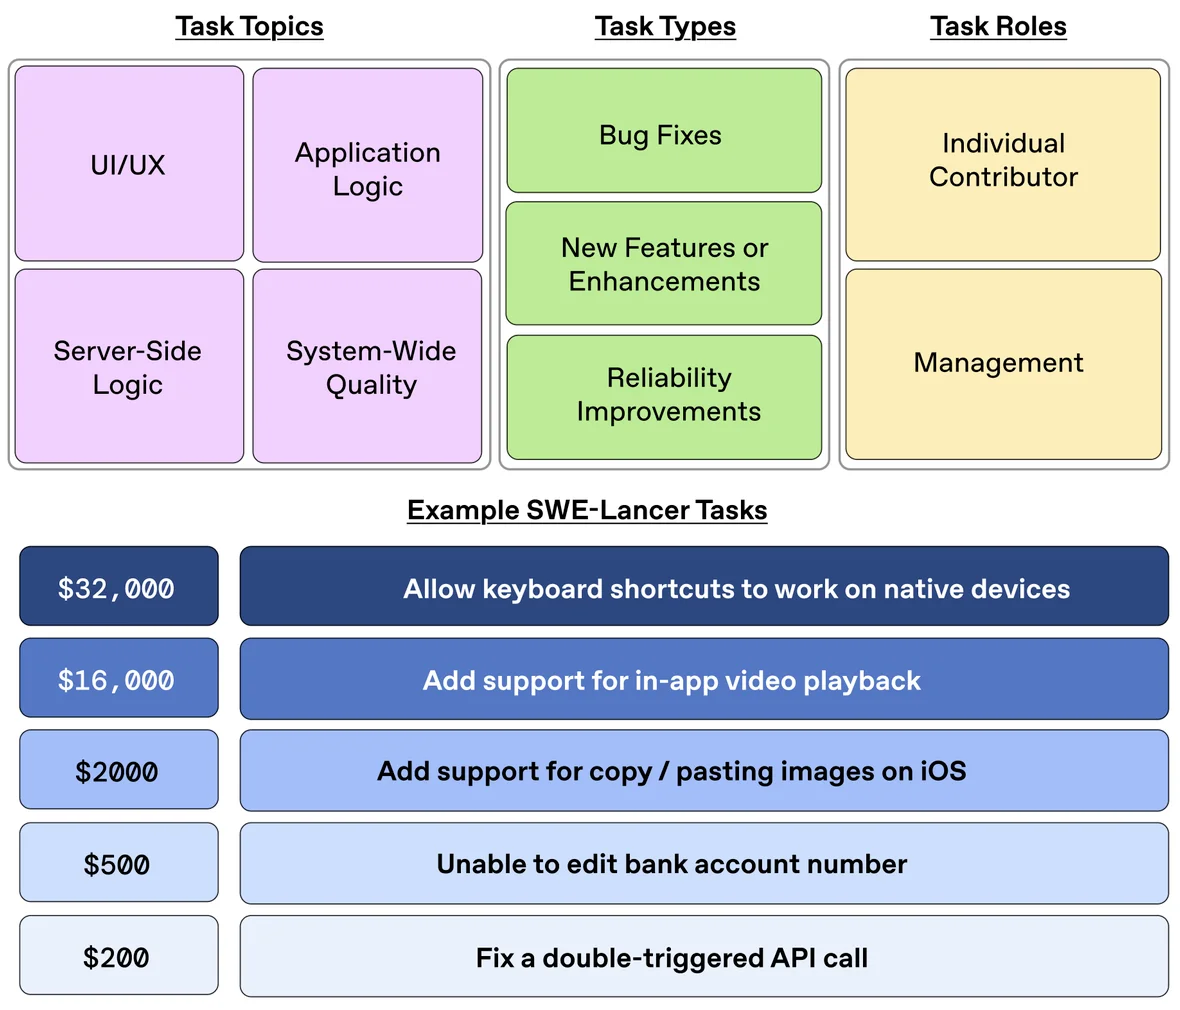
Vielfalt der Bewertungsaufgaben
SWE-Lancer umfasst eine breite Palette von Softwareentwicklungsaufgaben, was es zu einem äußerst effektiven Werkzeug zur Analyse der Modellfähigkeiten macht. Es verlangt vom Modell, aus mehreren vorgegebenen Optionen die beste Lösung auszuwählen. Diese Vorgehensweise spiegelt die Arbeitsabläufe von Engineering-Teams realitätsnäher wider.
Wirtschaftliche Wertbewertung
Dieser Benchmark bewertet nicht nur technische Fähigkeiten, sondern berücksichtigt auch den wirtschaftlichen Wert der Aufgaben. Diese Bewertungsmethode eröffnet eine neue Perspektive zur Messung der Effektivität von Modellen in realen Anwendungen und ermöglicht es Entwicklern, den potenziellen wirtschaftlichen Nutzen von KI-Modellen besser zu verstehen.
Funktionsmerkmale von SWE-Lancer:
Reale Aufgaben: SWE-Lancer enthält eine Reihe realer Softwareentwicklungsaufgaben, die von kleinen Bugfixes bis hin zur Implementierung umfangreicher Funktionen reichen, um sicherzustellen, dass Modelle in tatsächlichen Entwicklungsszenarien effektiv bewertet werden.
End-to-End-Tests: Im Gegensatz zu herkömmlichen Unit-Tests verwendet SWE-Lancer ein End-to-End-Testverfahren, das vom Modell verlangt, vollständige Probleme zu bearbeiten, und dem Entscheidungsprozess von Softwareingenieuren in der Praxis näher kommt.
Bewertung mit Mehrfachauswahl: Das Modell muss aus mehreren möglichen Lösungen den besten Vorschlag auswählen, was den Entscheidungsprozess simuliert, dem Engineering-Teams beim Auftreten von Problemen gegenüberstehen.
Wirtschaftliche Wertzuordnung: Der Gesamtwert der Aufgaben beträgt 1 Million US-Dollar, was zum einen die Komplexität und Bedeutung der Aufgaben verdeutlicht und zum anderen den potenziellen wirtschaftlichen Einfluss der Modellergebnisse aufzeigt.
Anwendungen von SWE-Lancer:
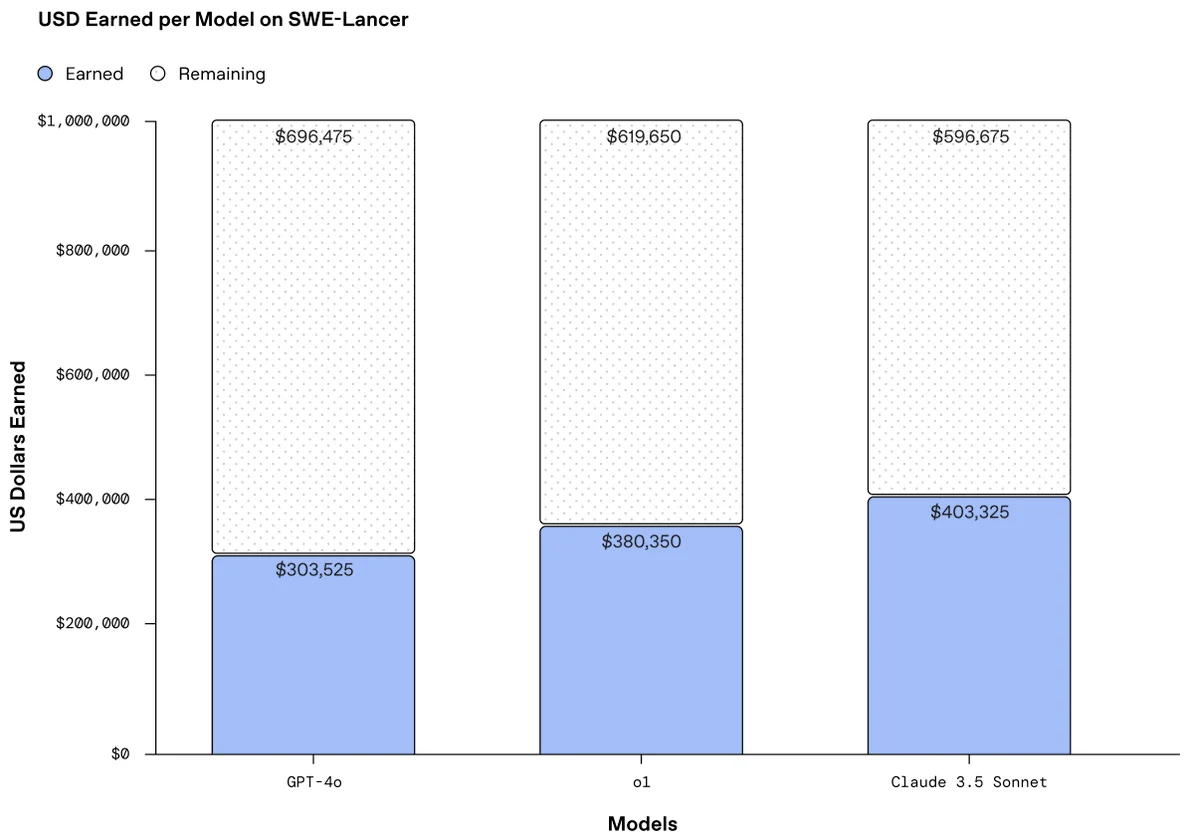
Leistungsbewertung von Modellen: Bietet Forschern und Entwicklern eine Plattform zum Testen und Vergleichen großer Sprachmodelle bei Softwareentwicklungsaufgaben.
Unterstützung der Softwareentwicklung: Auf lange Sicht könnte SWE-Lancer dazu beitragen, den Einsatz von künstlicher Intelligenz in der Softwareentwicklung zu optimieren, beispielsweise bei automatisierten Code-Reviews und Vorschlägen zur Fehlerbehebung.
Bildung und Schulung: Kann als Lehrmittel dienen, um Studierenden und Entwicklern bewährte Verfahren und Herausforderungen der Softwareentwicklung zu vermitteln.
Branchenstandard: Hat das Potenzial, zum Branchenstandard für die Bewertung der Praxistauglichkeit von KI im Bereich Softwareentwicklung zu werden.
Verwendung von SWE-Lancer:
Aufgabenauswahl: Wählen Sie eine oder mehrere Aufgaben aus der von SWE-Lancer bereitgestellten Aufgabenliste aus, die bewertet werden sollen.
Modellverarbeitung: Geben Sie die ausgewählten Aufgaben in ein KI-Modell ein, das die Aufgaben entsprechend seines Trainings und seiner Fähigkeiten ausführt.
Ergebnisbewertung: Bewerten Sie die vom Modell erzeugten Ergebnisse, um zu prüfen, ob sie die vorab festgelegten Qualitätsstandards erfüllen, und analysieren Sie sie im Hinblick auf den wirtschaftlichen Wert der Aufgaben.
Paper:https://arxiv.org/abs/2502.12115
Details:https://openai.com/index/swe-lancer/









