
 脚本プランナー▸
 AIアプリ
 AIニュース
アリババ通義千問が次世代視覚言語モデルを発表:Qwen2.5-VL
小编 ·

アリババ通義千問が次世代視覚言語モデルを発表:Qwen2.5-VL
阿里Qwen2.5-VLは、阿里巴巴通義千問チームが発表した新しい視覚理解モデルです。このモデルは強力な視覚理解、エージェント、長動画理解、イベント捕捉能力を備えており、aiの多様な分野での応用と発展を推進することを目的としています。
Qwen2.5-VLの主な機能
視覚理解:Qwen2.5-VLは画像内の一般的な物体(花、鳥、魚、昆虫など)を正確に識別でき、さらに画像内のテキスト、チャート、アイコン、図形、レイアウトを分析することができます。これにより、視覚情報を処理する際に優れた性能を発揮し、ユーザーに詳細な画像分析結果を提供できます。
動画理解:このモデルは1時間を超える動画の理解を突破的にサポートし、動画内の具体的なイベントを識別・解析することができます。この機能により、Qwen2.5-VLは動画コンテンツの分析と処理において顕著な優位性を持ちます。
動的推論能力:Qwen2.5-VLは動的推論能力を備え、視覚環境とテキスト指示に基づいて複雑な意思決定や操作を行うことができます。これにより、AI視覚エージェントとしてスマートフォンやパソコンなどを直接操作することが可能です。
複数サイズバージョン:Qwen2.5-VLは3B、7B、72Bという3つの異なる規模のモデルを提供しており、ユーザーはニーズに応じて適切なバージョンを選択し、異なる計算リソースとアプリケーションシナリオに対応できます。
主な特徴
複数サイズバージョン
3B、7B、72Bの3つの異なるパラメータ数のバージョンを提供し、それぞれ異なるアプリケーションシナリオとハードウェア構成に適しています。
3Bバージョン:モバイル端末やその他のリソース制限のある環境に適しています。
7Bバージョン:パフォーマンスとリソース消費のバランスが取れており、ほとんどのアプリケーションシナリオに適しています。
72Bバージョン:最高のパフォーマンスバージョンで、高精度と強力な機能を必要とするアプリケーションに適しています。
先進的な機能
視覚位置特定能力:画像内のオブジェクトを正確に識別し、座標形式で位置情報を返すことができます。
汎用画像認識:一般的な物体(花、鳥、魚など)を識別できるだけでなく、画像内のテキスト、チャート、アイコンなどの要素を分析することもできます。
ドキュメント解析:ドキュメントやテーブルの理解能力が大幅に向上し、特に学術的な問題解決、数学能力、ドキュメント検証などの分野で優れた性能を発揮します。
動画理解:長時間動画(時間単位)の理解をサポートし、秒単位のイベント位置特定能力を備え、動画の要点を要約し重要な情報を抽出することができます。
視覚エージェント:特定のタスクのファインチューニングなしでパソコンやモバイルを操作し、複雑な推論や意思決定タスクを実行できます。
文字認識と理解:OCR認識能力が強化され、複数シナリオ、複数言語、複数方向の文字認識と情報抽出をサポートしています。
改善点
時空間認識能力:モデルが時間と空間のスケールを認識する能力を強化し、さまざまなタイプのデータをよりよく理解し処理できるようにしました。
ネットワーク構造の簡素化:ウィンドウアテンション機構を導入し、計算負荷を軽減し、モデルの効率を向上させました。
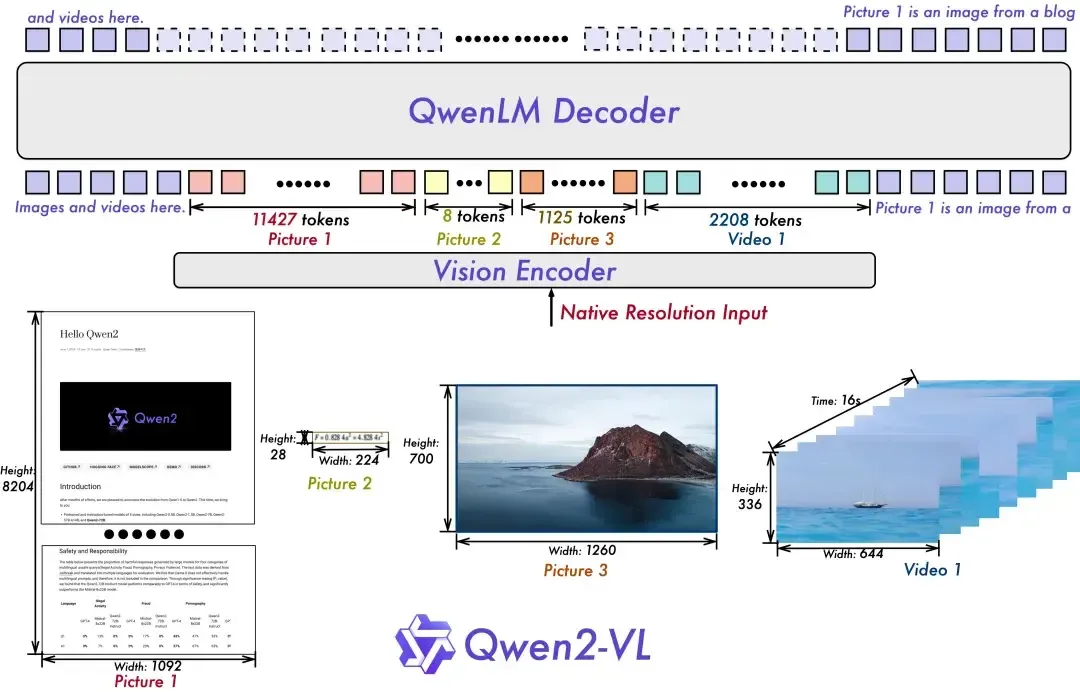
動的解像度:ネイティブ動的解像度のViTを使用し、モデルがネイティブ解像度を維持しながら計算負荷を低減することを保証します。
パフォーマンス
複数のベンチマークテストでリード:複数の分野のベンチマークテストで優れたパフォーマンスを示し、特にドキュメント理解、視覚質問応答、動画理解、視覚エージェントなどの多くのタスクで同種の競合モデルを凌駕しています。
具体的なケース:
ドキュメント理解:DocVQAなどのタスクで優れたパフォーマンスを発揮します。
動画理解:数時間に及ぶ動画内容を正確に理解し、重要なイベントを迅速に特定して要約することができます。
視覚エージェント:追加の調整なしで、デバイスやソフトウェアインターフェースの制御など、複雑な自動化タスクを実行できます。
Qwen2.5-VLのアプリケーションシナリオ
スマートカスタマーサービス:Qwen2.5-VLは動画カスタマーサービスのシナリオに適用でき、ユーザーが表示した商品画像やバーコードをリアルタイムで分析し、関連する商品情報を提供できます。
金融・商業分野:このモデルは構造化出力をサポートしており、請求書やフォームなどのデータ処理に対応し、特に金融・商業分野のアプリケーションに適しています。
教育とトレーニング:教育分野では、Qwen2.5-VLを使用して教育動画を分析し、学生が複雑な概念や内容を理解するのを支援できます。
医療画像分析:このモデルの視覚理解能力は医療画像分析にも適用でき、医師がより正確に画像データを解釈するのを支援できます。
Qwen2.5-VLモデルは前世代のQwen-VLの構造を継承し、ViT(視覚変換器)とQwen2の連結構造を採用しており、画像と動画の統一入力をサポートしています。この設計により、モデルが視覚情報と言語情報をよりよく融合し、マルチモーダルデータの理解能力を向上させることができます。さらに、Qwen2.5-VLはマルチモーダル回転位置符号化(M-ROPE)を導入し、位置符号化を時間、空間(高さと幅)の3つの部分に分解することで、モデルのマルチモーダル処理と推論能力を強化しています。このモデルは任意の解像度の画像認識能力を備えており、異なる解像度とアスペクト比の画像を処理し、入力と画像情報の一貫性を確保することができます。
Qwen2.5-VLの取得方法:
オープンソースアドレス:Hugging Face
Github:Qwen2.5-VL
オンライン体験:Qwen Chat









