
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
Alibaba veröffentlicht offiziell das Open-Source-Großmodell Qwen2.5-1M
小编 ·

Alibaba veröffentlicht offiziell das Open-Source-Großmodell Qwen2.5-1M
Alibaba hat am 27. Januar 2025 offiziell das Open-Source-Großmodell Qwen2.5-1M vorgestellt. Es ist das erste Mal, dass das Tongyi-Qianwen-Team die Kontextlänge eines Open-Source-Modells auf 1 Million Tokens (entspricht etwa 10 langen Romanen oder 30.000 Zeilen Code) erweitert und dabei einen signifikanten Durchbruch in der Leistung bei der Verarbeitung langer Texte erzielt hat.
1. Hauptmerkmale von Qwen2.5-1M
Unterstützung für ultralangen Kontext: Das Modell Qwen2.5-1M unterstützt eine Kontextverarbeitung von bis zu 1 Million Tokens, was etwa 1 Million englischen Wörtern oder 1,5 Millionen chinesischen Zeichen entspricht. Diese Eigenschaft ermöglicht es dem Modell, lange Dokumente wie Bücher, juristische Unterlagen und umfangreiche Berichte zu verarbeiten, ohne dass eine umständliche Textaufteilung erforderlich ist.
Verschiedene Modellgrößen: Die diesmal veröffentlichten Modelle umfassen Qwen2.5-7B-Instruct-1M und Qwen2.5-14B-Instruct-1M, die unterschiedliche Parametergrößen bieten, um den Anforderungen verschiedener Anwendungsszenarien gerecht zu werden.
Effizientes Inferenz-Framework: Das Qwen-Team hat ein auf vLLM basierendes Inferenz-Framework als Open Source veröffentlicht, das einen Sparse-Attention-Mechanismus integriert. Dadurch wird die Geschwindigkeit bei der Verarbeitung von 1M-Token-Eingaben um das 3- bis 7-fache gesteigert. Diese Effizienz ermöglicht es Entwicklern, das Modell schneller bereitzustellen und anzuwenden.
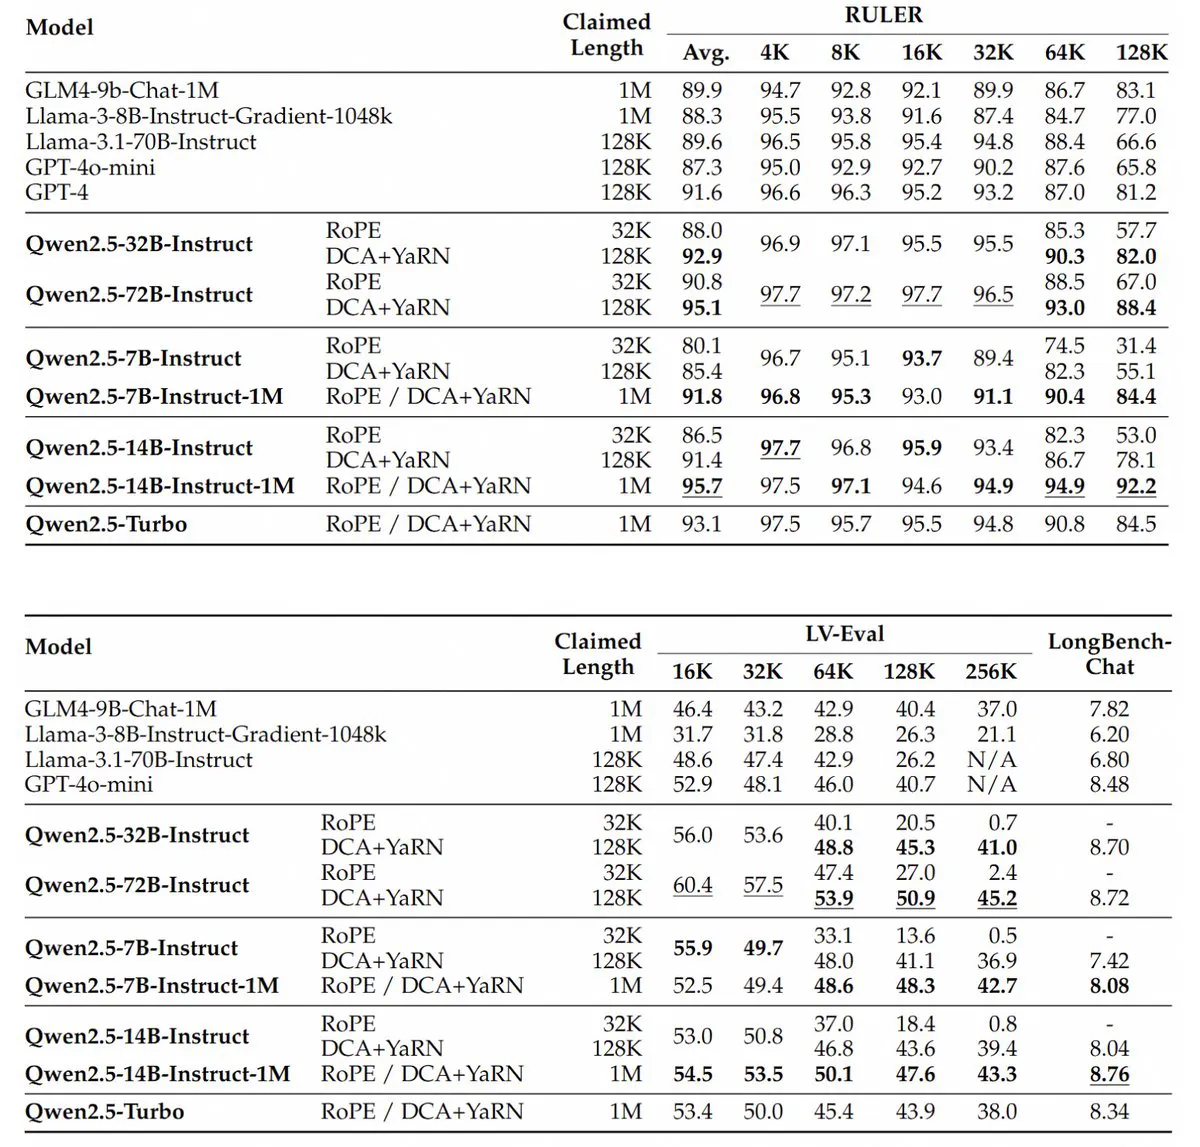
Leistungsvorteile: Bei Aufgaben mit langen Texten schneidet das Modell Qwen2.5-1M deutlich besser ab als die vorherige 128K-Version, insbesondere bei Aufgaben mit mehr als 64K Länge zeigt es eine stärkere Leistungsfähigkeit.
2. Modelleigenschaften und Leistung
Fähigkeit zur Verarbeitung langer Kontexte
Unterstützung für 1 Million Tokens: Die Qwen2.5-1M-Serie umfasst zwei Versionen, 7B und 14B, und unterstützt nativ eine Kontextlänge von 1M Tokens. Sie kann lange Dokumente, Code-Repositorys oder komplexe mehrteilige Dialoge verarbeiten, ohne dass eine segmentierte Eingabe erforderlich ist.
Präzise Suche und Verständnis: In der „Passkey Retrieval"-Aufgabe kann das Modell versteckte Informationen aus 1M-Token-Dokumenten genau extrahieren; nur die 7B-Version zeigt vereinzelte Fehler. In Benchmark-Tests zum Verständnis langer Texte wie RULER und LV-Eval übertrifft die 14B-Version stabil das eigene Closed-Source-Modell Qwen2.5-Turbo sowie GPT-4o-mini von Openai.
Kompatibilität mit Kurztextaufgaben
Die 7B- und 14B-Modelle schneiden bei Kurtextaufgaben (wie Frage-Antwort-Systemen und Zusammenfassungen) vergleichbar gut ab wie die 128K-Version, ohne dass die Grundleistung durch die erweiterte Langtextfähigkeit beeinträchtigt wird. Beispielsweise erreicht das 14B-Modell bei Kurztextaufgaben eine Leistung nahe an GPT-4o-mini, verfügt jedoch über die achtfache Kontextlänge.
3. Technologische Durchbrüche und Open-Source-Framework
Progressives Training und Längenextrapolation
Stufenweise Erweiterung: Vom Pre-Training bis zum überwachten Feintuning wird die Kontextlänge schrittweise von 4K auf 256K erweitert, und anschließend wird die Ausrichtung an Kurtexten durch Reinforcement Learning optimiert.
Dual Chunk Attention (DCA): Eine innovative Technik zur Extrapolation von Positionskodierungen wird eingeführt, mit der die vom Modell unterstützte Kontextlänge ohne zusätzliches Training von 256K auf 1M erweitert werden kann. Dadurch wird das Problem der Aufmerksamkeitsverschlechterung bei langen Positionskodierungen gelöst.
Effiziente Inferenzoptimierung
Sparse-Attention-Mechanismus: Basierend auf dem vLLM-Framework wird Sparse Attention (MInference) integriert. In Kombination mit Chunked Prefill und dynamischer Parallelisierung wird die Inferenzgeschwindigkeit bei 1M-Token-Eingaben um das 3,2- bis 6,7-fache gesteigert und der Speicherverbrauch deutlich reduziert (z. B. Reduzierung des Aktivierungsspeichers beim 7B-Modell um 96,7 %).
Open-Source-Framework-Unterstützung: Das Inferenz-Framework und der technische Trainingsbericht werden vollständig als Open Source veröffentlicht. Entwickler können das Modell schnell bereitstellen und von FP8-Quantisierung zur Senkung der Hardwareanforderungen profitieren.
4. Anwendungsszenarien
Textgenerierung: Das Modell Qwen2.5-1M kann zur Erstellung langer Artikel, Berichte und Geschichten verwendet werden und eignet sich für Bereiche wie Content-Erstellung und journalistisches Schreiben.
Informationsbeschaffung: Dank der Fähigkeit zur Handhabung ultralanger Kontexte kann das Modell effektiv Informationen aus langen Texten abrufen und eignet sich damit für Branchen wie Recht und Medizin, in denen große Dokumentenmengen verarbeitet werden müssen.
Dialogsysteme: Das Modell kann zum Aufbau intelligenter Dialogsysteme eingesetzt werden, die komplexe Dialoginhalte verstehen und generieren können, um das Benutzererlebnis zu verbessern.
Multimodale Anwendungen: Das Design von Qwen2.5-1M ermöglicht die Kombination mit anderen Modalitäten (wie Bild und Audio) und erweitert damit den Anwendungsbereich auf multimodale Verständnis- und Generierungsaufgaben.
Die Veröffentlichung von Qwen2.5-1M schließt nicht nur die Lücke bei Open-Source-Modellen im Umgang mit ultralangen Kontexten, sondern bietet Entwicklern durch technologische Innovation und ein offenes Ökosystem auch eine leistungsstarke Werkzeugauswahl mit niedriger Einstiegshürde. Ihr Erfolg könnte die globale KI-Branche bei der Erforschung von Langtext-Anwendungen beschleunigen und die Rolle der Open-Source-Community im Rennen um die AGI stärken.









