
 Asistente de guiones▸
 Apps AI
 Noticias AI
FunAudioLLM: el avance de Alibaba en IA de voz
小编 ·

FunAudioLLM: el avance de Alibaba en IA de voz
FunAudioLLM es un conjunto de modelos de procesamiento de voz desarrollado por Alibaba, diseñado para mejorar la interacción por voz entre humanos y modelos de lenguaje grandes. Está compuesto por dos modelos principales: SenseVoice y CosyVoice.
SenseVoice: un modelo de reconocimiento de voz capaz de identificar voz en múltiples idiomas, reconocer las emociones del hablante y detectar eventos especiales en el audio (como música, risas, etc.). Puede transcribir el contenido de voz de forma rápida y precisa.
CosyVoice: un modelo de generación de voz que genera principalmente voz natural y rica en emociones. Puede imitar a diferentes hablantes e incluso clonar la voz de una persona con solo unos segundos de muestra de audio.
A través de la combinación de SenseVoice y CosyVoice, FunAudioLLM ofrece capacidades integrales de comprensión y generación de voz, haciendo que la interacción por voz entre humanos y modelos de lenguaje grandes sea más natural y enriquecedora.
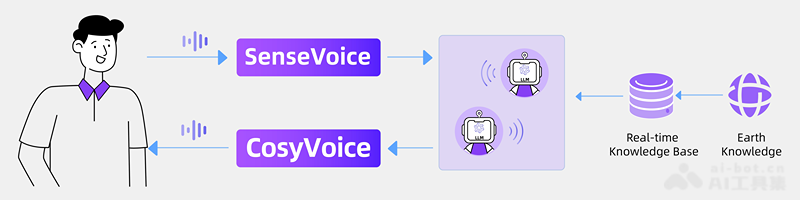
Características principales de SenseVoice y CosyVoice:
SenseVoice se centra en el reconocimiento de voz multilingüe, el reconocimiento de emociones y la detección de eventos de audio, ofreciendo capacidades de procesamiento de voz de alta precisión y baja latencia. CosyVoice se centra en la generación y el control de voz natural, admitiendo la generación en múltiples idiomas, timbres y estilos de habla, y permite el aprendizaje sin ejemplos y el control de voz de grano fino. La combinación de ambos permite a FunAudioLLM ofrecer una experiencia de interacción por voz excelente en múltiples escenarios de aplicación.
Características principales de SenseVoice
1. Reconocimiento de voz multilingüe
SenseVoice-Small: admite cinco idiomas: chino, inglés, cantonés, japonés y coreano. Utiliza una arquitectura de extremo a extremo no autorregresiva, con una latencia de reconocimiento extremadamente baja. Es 5 veces más rápido que Whisper-small y 15 veces más rápido que Whisper-large.
SenseVoice-Large: reconocimiento de voz de alta precisión, admite más de 50 idiomas.
2. Reconocimiento de emociones
Identifica emociones en el habla, como felicidad, tristeza, enojo, etc., mediante la detección de cambios en el tono, el ritmo y la entonación del habla.
3. Detección de eventos de audio
Detecta eventos especiales en el habla, como música, risas, aplausos, etc., y predice las horas de inicio y finalización de los eventos.
SenseVoice-Small puede detectar varios eventos de interacción humano-máquina, como música de fondo, aplausos, risas, llantos, tos, estornudos, etc.
4. Identificación de idiomas
Capaz de identificar el idioma utilizado por el hablante para garantizar la precisión del reconocimiento de voz y la comprensión del contexto.
5. Normalización inversa del texto (ITN)
Proporciona resultados de transcripción con puntuación y formato para mejorar la legibilidad y precisión del texto transcrito.
Características principales de FunAudioLLM:
Reconocimiento de voz multilingüe: más de 400.000 horas de datos de entrenamiento, con un rendimiento de reconocimiento superior al de los modelos Whisper.
Inferencia eficiente: el modelo SenseVoice-Small adopta un marco de extremo a extremo no autorregresivo, con una latencia de inferencia extremadamente baja. Procesar 10 segundos de audio solo toma 70 milisegundos, 15 veces más rápido que Whisper-Large.
Reconocimiento de emociones: alcanza los mejores resultados de los modelos actuales de reconocimiento de emociones en varios conjuntos de datos de prueba.
Detección de eventos: admite la detección de múltiples eventos de audio comunes.
Ajuste fino conveniente: proporciona scripts y estrategias de ajuste fino convenientes, lo que permite a los usuarios resolver fácilmente problemas de muestras de cola larga según los escenarios empresariales.
Despliegue de servicios: ofrece pipelines de despliegue de servicios que admiten múltiples solicitudes concurrentes, con lenguajes de cliente que incluyen Python, C++, HTML, Java, C#, etc.
Características principales de CosyVoice:
1. Generación de voz
Admite la generación de voz multilingüe, incluyendo chino, inglés, cantonés, japonés y coreano.
Capaz de generar voz natural y rica en emociones, admitiendo diferentes estilos de habla y expresiones emocionales.
2. Control de voz diversificado
Control de timbre: puede controlar con precisión el timbre de la voz generada para que coincida con la voz de un hablante específico.
Control del estilo de habla: controla el estilo de habla de la voz mediante comandos de texto, como emoción, velocidad, tono, etc.
3. Aprendizaje sin ejemplos
Solo se necesitan unos segundos de muestra de audio para clonar una voz, sin necesidad de datos de entrenamiento adicionales.
Admite la clonación de voz entre idiomas, lo que le permite hablar con la voz de un idioma en otro idioma.
4. Control de grano fino de características paralingüísticas
Admite la inserción de características de voz sutiles como risas, respiraciones y partículas de habla, haciendo que la voz generada sea más natural y vívida.
Control mediante comandos de texto: a través de comandos de texto se puede controlar con precisión la identidad, la emoción y el estilo de habla del hablante.
5. Conversación entre múltiples personajes
Puede generar voz de conversación entre múltiples personajes, adecuada para escenarios como podcasts interactivos y chats emocionales.
Dirección del proyecto: https://github.com/FunAudioLLM









