
 Drehbuch-Assistent▸
 AI Apps
 AI Nachrichten
ViViD: Virtual-Try-On-Video mit Diffusionsmodellen
小编 ·

ViViD: Virtual-Try-On-Video mit Diffusionsmodellen
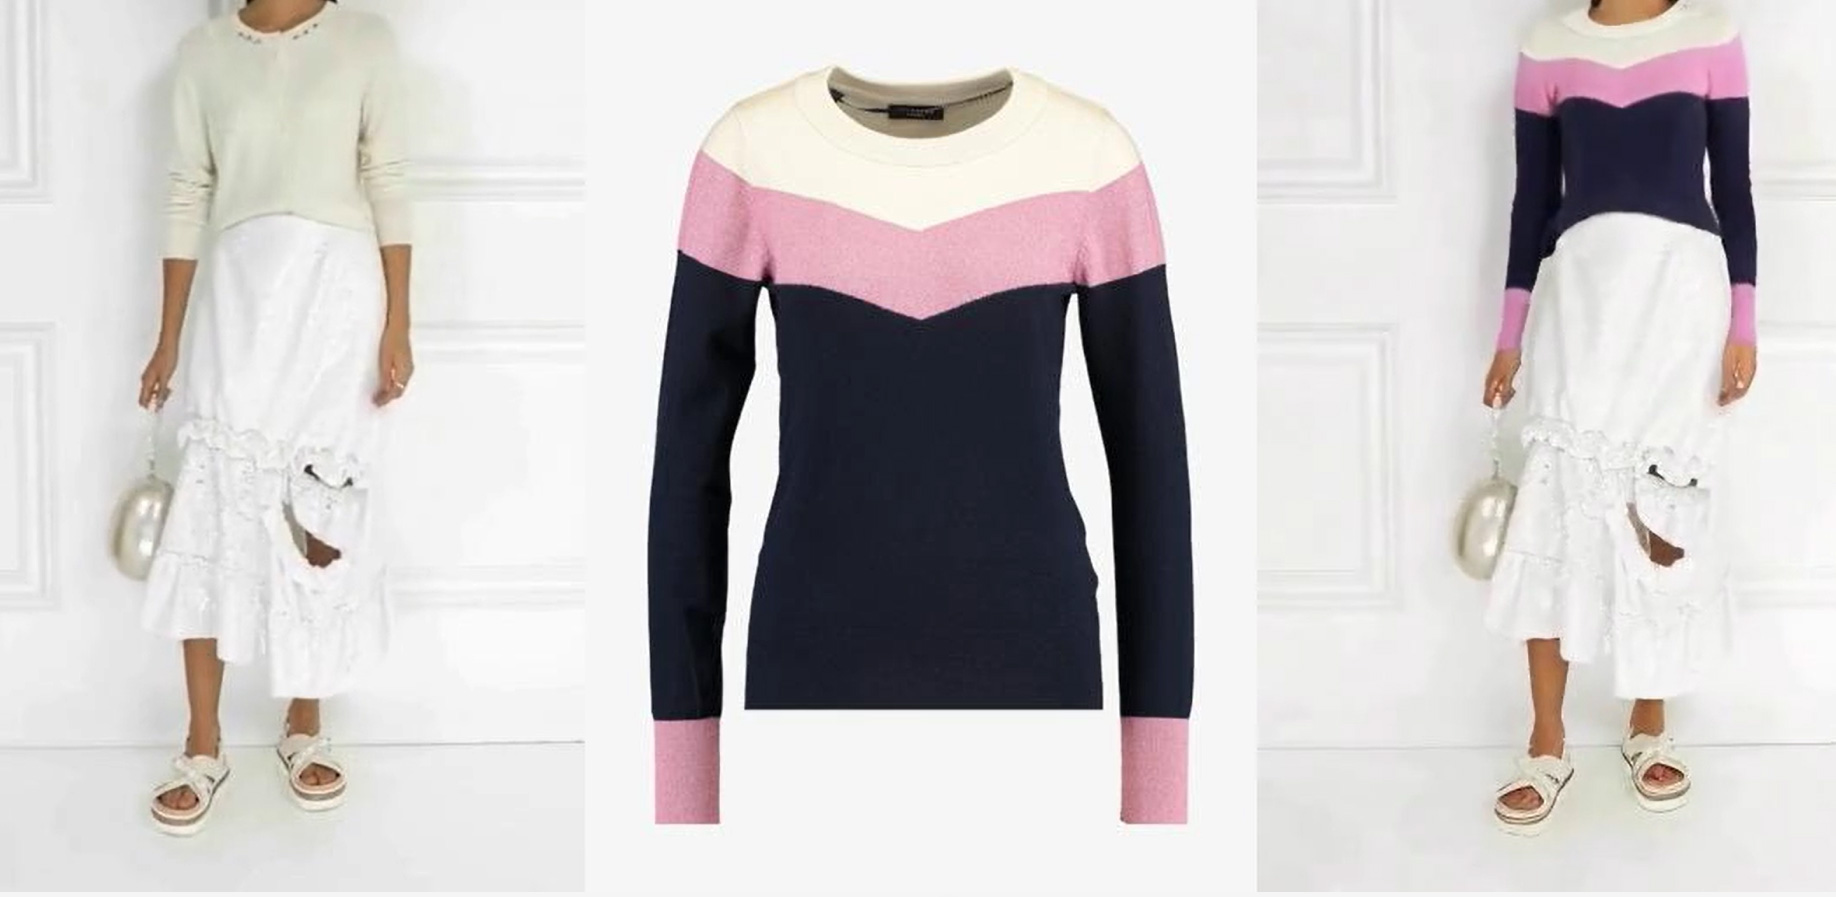
ViViD ist eine von Alibaba entwickelte Technologie für virtuelle Video-Anprobe, mit der die Kleidung von Personen in Videos beliebig ausgetauscht werden kann. ViViD kann natürliche und realistische Videos für virtuelle Anproben erzeugen und Kleidungsstücke auf Personen in Videos übertragen, während der übrige Teil des Videos unverändert bleibt.
ViViD-Demoseite: https://becauseimbatman0.github.io/ViViD
ViViD-Papieradresse: https://arxiv.org/abs/2405.11794
Mit der rasanten Entwicklung des E-Commerce können Verbraucher über Online-Plattformen wie Taobao und JD.com bequem auf verschiedene Arten von Kleidung zugreifen. Allerdings ist es für Verbraucher schwierig, sich vorzustellen, wie die Kleidung an ihnen selbst aussieht, wenn sie sich nur auf die Kleidungsbilder auf E-Commerce-Websites verlassen. Obwohl die Technologie des bildbasierten Kleidungswechsels bereits relativ ausgereift ist, ist der Kleidungswechsel in Videos, insbesondere in Bezug auf die Interaktion mit Körperbewegungen, noch selten anzutreffen.
Bei virtuellen Anprobevideos wird die Kleidung auf die Zielperson übertragen. Die direkte Anwendung bildbasierter Anprobetechniken auf den Videobereich Bild für Bild führt zu zeitlich inkonsistenten Ergebnissen, während frühere videobasierte Anprobelösungen nur Ergebnisse mit geringer visueller Qualität und Unschärfe liefern konnten.
Das von einem gemeinsamen Forschungsteam der University of Science and Technology of China und der Alibaba Group entwickelte ViViD-System für virtuelle Videoanproben zielt darauf ab, dieses Problem durch Videosynthese zu lösen, damit Verbraucher die realistische Wirkung der Kleidung an ihrem eigenen Körper sehen können. Dieses Video-Framework nutzt Diffusionsmodelle (Diffusion Models), um hochwertige und konsistente Anprobevideos zu erzeugen.
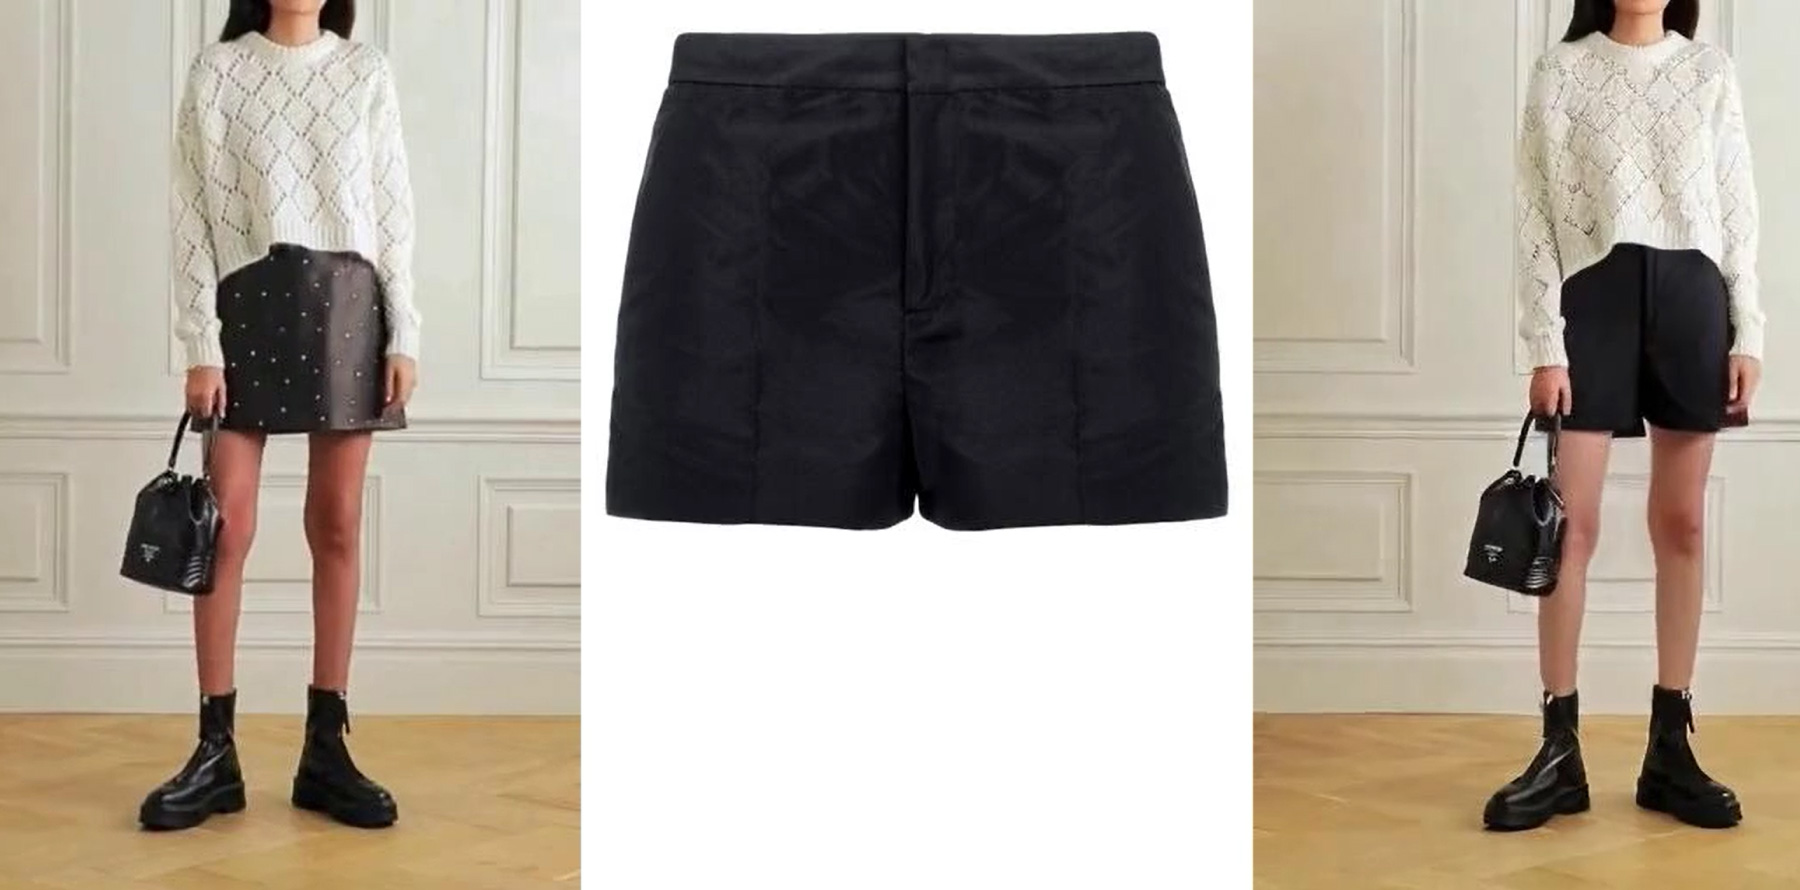
Konkreter gesagt haben wir einen Kleidungs-Encoder entwickelt, um feinkörnige semantische Merkmale der Kleidung zu extrahieren, der das Modell anleitet, Kleidungsdetails zu erfassen und sie über den vorgeschlagenen Aufmerksamkeits-Feature-Fusionsmechanismus in das Zielvideo einzubringen. Um die raumzeitliche Konsistenz sicherzustellen, führen wir einen leichtgewichtigen Pose-Encoder ein, der Posensignale kodiert, sodass das Modell die Wechselwirkungen zwischen Kleidung und Körperpose erlernen kann, und integrieren hierarchische Zeitmodule in das Text-zu-Bild-Stable-Diffusion-Modell, um eine kohärentere und realistischere Videosynthese zu erzielen.
Darüber hinaus haben wir einen neuen Datensatz zusammengetragen, der bisher der größte, kleidungstypenmäßig vielfältigste und höchstaufgelöste Datensatz für die Aufgabe der virtuellen Videoanprobe ist. Umfangreiche Experimente zeigen, dass unsere Methode zufriedenstellende Ergebnisse bei der Videoanprobe erzielen kann. Der Datensatz, der Code und die Gewichte werden öffentlich zugänglich gemacht.









